Fiche de la vidéo
| Élément | Détail |
|---|---|
| Titre | Masterclass agent IA en local, de zéro à pro |
| Auteur | Naier Saidane (L'Accélérateur IA), coach pour freelances qui vendent des services IA |
| Publication | 15 octobre 2026, environ 1h55, en français, démos sur Mac mini M4 16 Go |
| Public cible | indépendants et intégrateurs qui veulent vendre une offre « IA confidentielle » à des PME et professions réglementées |
| Fil rouge | trois conditions pour vendre : la bonne machine, la bonne réponse à « où vont mes données », le bon client |
L'étude Pegatron, la référence utilisée dans chaque partie
La vidéo montre ce qu'on peut faire sur une petite machine. L'étude Peng, Lin et Lee, « Inference Economics of Enterprise Coding Agents », arXiv 2607.13080 (juillet 2026) mesure un modèle ouvert de premier plan en production, face à Claude. Chaque partie se termine par un encadré qui confronte la vidéo à ces mesures.
Protocole. Un développeur de Pegatron (Taïwan) a travaillé deux fois 28 jours sur la même plateforme interne (Python et TypeScript) : d'abord avec Claude Code et Claude Opus via l'API, puis avec Opencode et GLM-5.1/5.2 quantifiés en NVFP4, servis par vLLM sur 4 GPU B200 en interne. La qualité est mesurée par le Fix Commit Ratio (FCR), la part des commits qui réparent un défaut.
| Indicateur | Claude Opus (API) | GLM local (NVFP4) |
|---|---|---|
| SWE-bench Pro | 69,2 % | 62,1 % |
| Vitesse d'écriture | 66 tok/s | environ 185 tok/s |
| Coût effectif par million de tokens | 0,57 $ (cache à 99,3 %) | 2,83 $ en partagé, 11,87 $ en dédié |
| Commits de réparation (FCR) | 45,9 % | 74,9 % |
| Coût total sur 28 jours, réparations comprises | 9 774 $ | 5 859 $ en partagé (−40 %), 14 051 $ en dédié (+44 %) |
Comment lire le coût local. L'étude valorise le matériel au prix de location du marché (4 $ par heure et par GPU), jamais comme gratuit. « Dédié » compte le plateau réservé 24 h sur 24 ; « partagé » ne compte qu'un siège de 160 h par mois sur un cluster mutualisé. Le coût total ajoute l'exploitation et le temps de réparation du code.
Ce qu'il faut en retenir
- Le local n'est rentable que mutualisé. Grâce au cache de prompt, l'API est moins chère au token que le serveur interne. Le serveur partagé bat l'API ; réservé à un seul développeur, il perd dans toutes les hypothèses testées.
- Un petit écart de benchmark devient un grand écart en production. Sept points sur SWE-bench Pro donnent, à difficulté égale, un risque de réparation 3,6 fois plus élevé selon le modèle statistique de l'étude : imports inventés, signatures obsolètes, erreurs de typage. La vitesse brute (2,8 fois plus rapide) ne compense pas.
- Router par difficulté coûte de la qualité. Envoyer les tâches difficiles vers Claude et le reste en local économise 26 % du coût total, mais la part de réparations monte à 65 %. L'hybride proposé dans cet article route d'abord par sensibilité de la donnée, pas par difficulté : il accepte ce compromis seulement là où la donnée ne peut pas sortir.
Limites. Un seul développeur sur un seul dépôt ; modèle, quantification et harness changent en même temps ; prix publics de l'API (une remise de 45 % annulerait l'avantage du local partagé) ; coûts taïwanais.
Partie 1 : comprendre la machine avant de choisir le modèle
Objectif de la partie : savoir prédire, avant tout achat, si un modèle tournera vite ou pas sur une machine donnée, et quand une API souveraine est le meilleur choix.
1.1 Qu'est-ce qu'une IA locale ?
Une IA est locale quand le modèle tourne sur une machine que l'on contrôle et qu'elle répond encore une fois le réseau coupé. On distingue quatre configurations :
| Configuration | Exemple | Où va la donnée |
|---|---|---|
| Service cloud | ChatGPT, Claude.ai | chez l'éditeur du modèle |
| Outil installé, modèle distant | Claude Code, Codex | chez l'éditeur : l'interface est locale, le modèle ne l'est pas |
| Serveur loué chez un hébergeur | GPU dédié chez OVHcloud ou Scaleway | chez l'hébergeur, sous droit européen |
| Modèle local | Ollama sur un Mac ou un PC | ne quitte pas les murs |
À retenir. Le test du wifi coupé distingue le local du reste. Un serveur loué en France est souverain, pas local.
1.2 La chaîne en cinq composants
- Le fichier du modèle : des milliards de nombres stockés sur disque ; il ne fait rien seul.
- Le moteur d'inférence : il lit le fichier et calcule le token suivant (llama.cpp sur toutes les machines, MLX sur Mac).
- L'application : Ollama ou LM Studio, qui téléchargent, chargent, affichent une interface et exposent une API.
- Le harness : le programme qui donne des outils et des instructions au modèle, et qui en fait un agent.
- Le matériel : c'est lui qui fixe les limites.
À retenir. On choisit une application, elle choisit le moteur. Un modèle ne devient un agent que si le harness lui donne des outils et qu'il sait les appeler.
1.3 Pourquoi la mémoire GPU décide de tout
Démonstration sur un Mac mini 16 Go : Mistral Small 3.2 (15 Go) met près de 10 minutes à répondre « bonjour », car 45 % du modèle est rejeté sur le CPU et la machine écrit sur le disque. Gemma 4 12B (7,7 Go), entièrement en GPU, répond en 17 secondes.
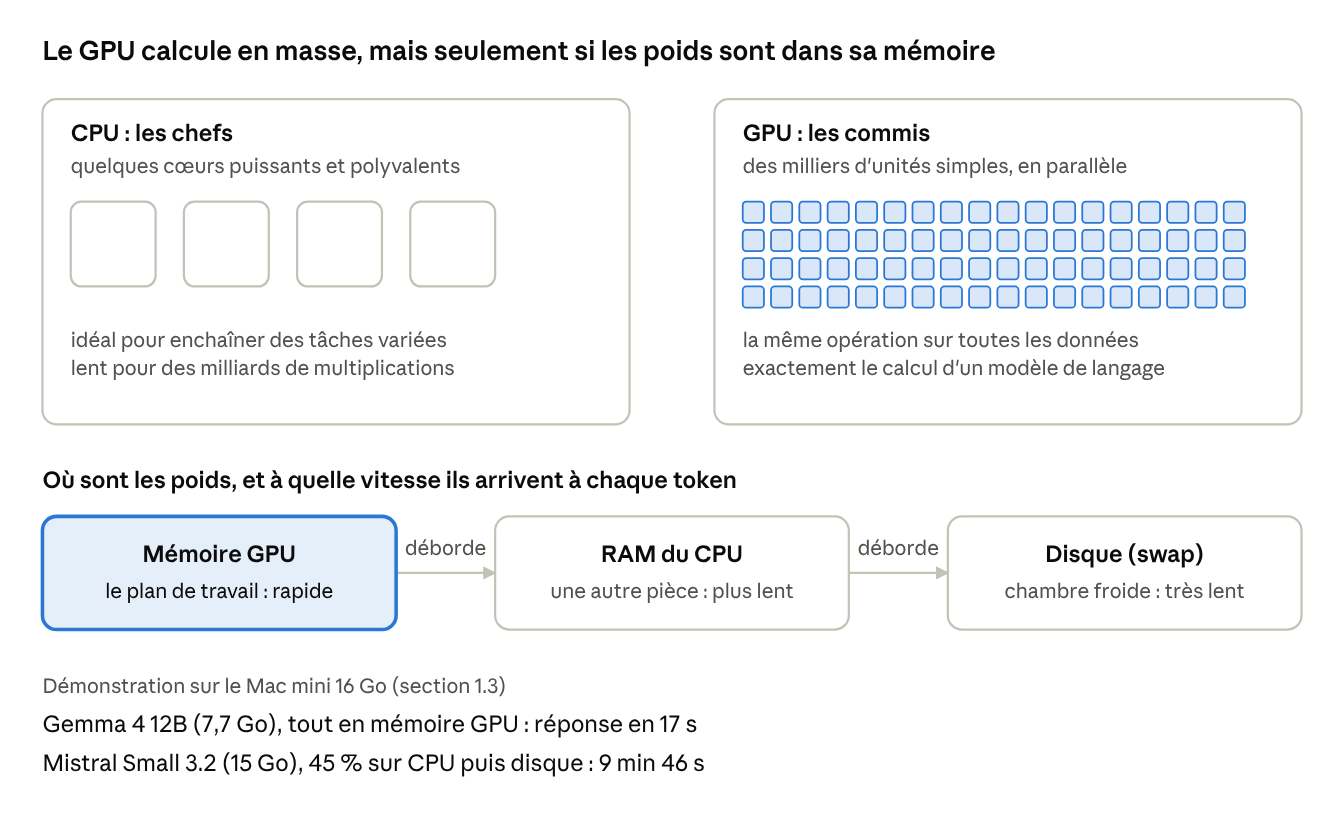
Le GPU fait le calcul d'un modèle de langage bien mieux que le CPU, mais il attend les poids : tant qu'ils sont dans sa mémoire, tout va vite ; dès qu'ils débordent vers la RAM puis le disque, chaque token attend.
À retenir. Le goulot n'est pas le calcul mais le transfert des poids. Un modèle qui tient en mémoire GPU est rapide ; un modèle qui déborde devient inutilisable (facteur 35 dans la démo).
1.4 Lire la mémoire réellement disponible
- Mac (mémoire unifiée) : macOS en garde une partie ; compter 2/3 à 3/4 de la RAM, soit 11,3 Go utilisables sur 16.
- PC avec carte graphique : la VRAM dédiée, visible dans le gestionnaire des tâches.
- Ce qui doit tenir : le fichier, plus le contexte (la mémoire de la conversation), plus une marge pour le moteur. Exemple : 7,7 Go de fichier occupent 8,1 Go avec 16 000 tokens de contexte.
- Règles pratiques : sur Mac, RAM d'au moins 2 fois le fichier pour un agent, 1,5 fois pour du chat court ; sur PC, VRAM égale au fichier plus 20 à 30 %.
À retenir. Le chiffre affiché sur la boîte n'est pas le bon. Mistral Small 3.2 demande 15 × 1,5 = 22 Go : il ne pouvait pas tenir sur 16.
1.5 Les quatre indicateurs de performance
| Indicateur | Ce qu'il mesure | Repère |
|---|---|---|
| Vitesse d'écriture | tokens produits par seconde | un humain lit 5 à 6 tok/s ; au-delà de 10, c'est confortable |
| Préfill | vitesse de lecture du prompt | décisif sur les longs documents et les agents |
| TTFT | temps avant le premier token | chargement du modèle + lecture du prompt |
| Contexte | mémoire de la conversation | un agent demande 32 000 à 64 000 tokens ; Ollama n'en donne que 4 096 par défaut sur cette machine |
La vitesse d'écriture se prévoit : bande passante ÷ poids lu à chaque token. Sur le Mac mini, 120 Go/s ÷ 7,6 Go donnent 16 tok/s au maximum ; on mesure 11 à 14.
À retenir. La vitesse d'écriture se calcule avant l'achat. Le préfill et le contexte sont les vrais pièges des agents : un modèle qui tient au chargement peut déborder en cours de conversation.
1.6 Le cas des modèles MoE (mélange d'experts)
Dans un modèle « Mixture of Experts », chaque couche feed-forward dense est remplacée par plusieurs réseaux plus petits, les experts. Un routeur choisit, pour chaque token, les quelques experts qui le traitent ; l'attention et les autres couches restent communes (Hugging Face). Les experts ne sont pas spécialisés par thème ni par langue : ils se partagent plutôt des familles de tokens (ponctuation, noms propres…).
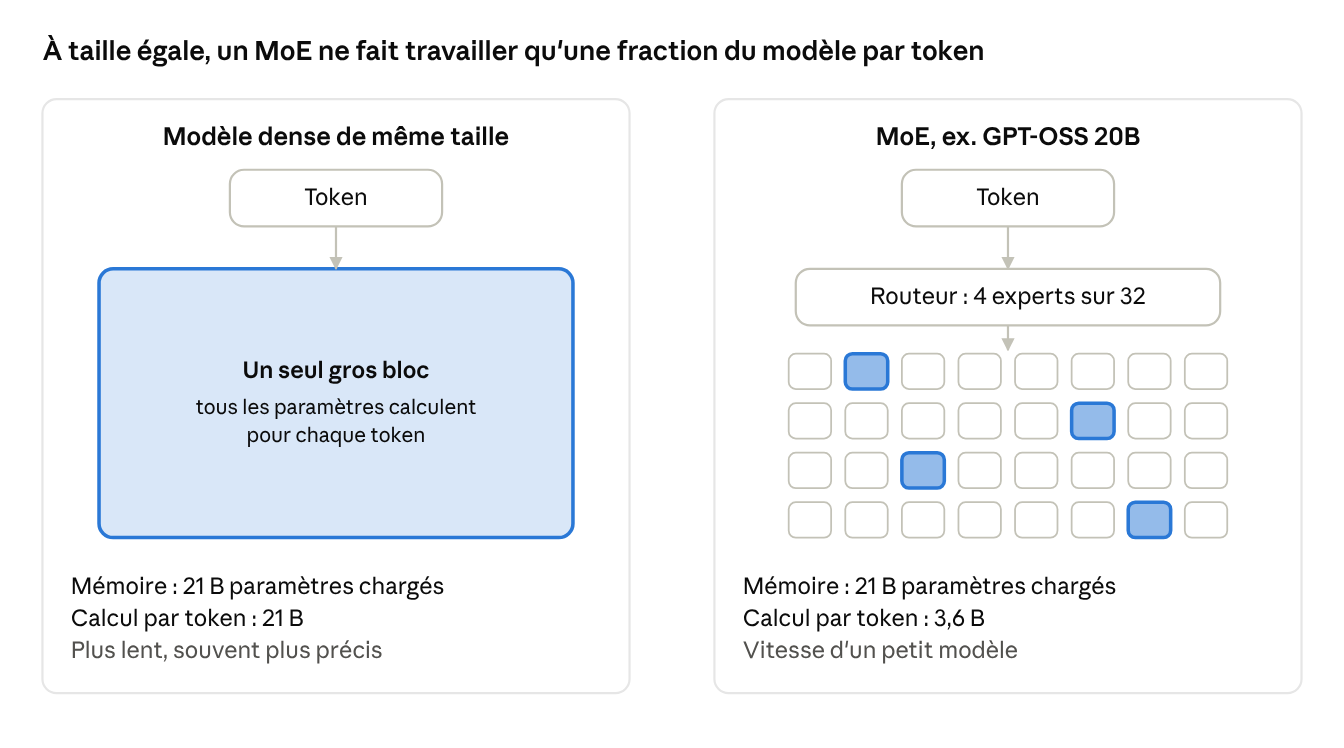
Démonstration : GPT-OSS 20B (21 B paramètres, 3,6 B actifs, 4 experts sur 32) déborde de la mémoire GPU, mais écrit à 17,8 tok/s contre 13,5 pour Gemma 4 12B, qui tient en mémoire. Seuls les poids actifs transitent à chaque token : la vitesse dépend des paramètres actifs (voir 1.5). En contrepartie, le token suivant peut appeler n'importe quel expert : tout le modèle reste en mémoire. Les grands modèles ouverts sont presque tous des MoE : Qwen3.5-397B-A17B (17 B actifs), GLM-5.2 (753 B, 40 B actifs).
À retenir. Un MoE a la vitesse d'un petit modèle et l'empreinte mémoire d'un gros. On économise du calcul, pas de la mémoire, et plus rapide ne veut pas dire meilleur.
1.7 Choisir où faire tourner le modèle : machine locale ou cloud souverain
Une fois le palier de modèle connu, deux mondes s'offrent : posséder la machine, ou consommer le modèle chez un hébergeur souverain. On n'y manipule pas les mêmes objets, et on n'y paie pas la même chose.
1.7.1 Ce qu'on manipule avec une machine locale
- La machine entière : achat, mémoire, électricité, pannes, remplacement.
- Le fichier du modèle et sa quantification : choix libre (Q4, Q8, BF16), dans la limite de la mémoire.
- Le moteur et ses réglages : contexte, parallélisme, conservation en mémoire (voir partie 2).
- La sécurité et les mises à jour : à la charge de celui qui exploite la machine (voir partie 4).
À retenir. En local, on paie une capacité fixe, qu'elle serve ou non. Si la charge dépasse cette capacité, tout ralentit ; si elle reste en dessous, on a payé pour rien.
1.7.2 Ce qu'on manipule chez un cloud souverain
| Formule | Exemples | Ce qu'on manipule | Ce qu'on paie | Ce qu'on ne choisit pas |
|---|---|---|---|---|
| API au token | Scaleway Generative APIs, OVHcloud AI Endpoints | une URL, une clé et un nom de modèle, comme avec Ollama | chaque million de tokens consommé | le catalogue, la quantification (OVHcloud affiche FP8 ou BF16), les performances, variables sur une infrastructure mutualisée |
| Inférence dédiée managée | Scaleway Managed Inference, OVHcloud AI Deploy | un point d'accès réservé, sans administration système | le temps d'allocation, à la minute ou à l'heure | une partie de la configuration du serveur |
| GPU dédié | instances GPU Scaleway, Cloud GPU OVHcloud | une machine virtuelle sur laquelle on installe vLLM ou Ollama | chaque heure où la machine est allumée, qu'elle serve ou non | rien côté logiciel, mais on retrouve toute l'exploitation du local |
À retenir. L'API au token est la formule naturelle pour consommer un modèle souverain : on ne paie que ce qu'on consomme. Le GPU dédié ne se justifie qu'avec une charge constante ou un modèle absent des catalogues.
1.7.3 Les paliers de modèle et leurs équivalents
Côté machine locale : quelle machine pour quel palier
| Palier (taille du fichier en Q4) | Mémoire GPU | Machine | Prix d'achat indicatif |
|---|---|---|---|
| 7–9 B (environ 5 Go) | 8 Go | carte 8 Go ou Mac 16 Go | moins de 1 500 € |
| 12–14 B (7–9 Go) | 12 Go | carte 12 Go ou Mac 16 Go | moins de 1 500 € |
| 27–32 B (16–20 Go) | 24 Go | carte 24 Go ou Mac 32–48 Go | 1 489 à 3 659 € |
| 35–50 B, souvent MoE (20–30 Go) | 32–40 Go | carte 32 Go ou Mac 48–64 Go | à partir de 3 659 € |
| 70–120 B (40–80 Go) | 48–96 Go | deux cartes, Mac Studio 64–128 Go ou DGX Spark | 6 000 à 7 800 € |
| 280 B à 2,8 T (155 Go à 1,5 To) | 160 Go à plus de 1 To | Mac Studio 256–512 Go ou plusieurs DGX Spark | plus de 10 000 € ; environ 19 200 € pour 4 DGX Spark |
Côté cloud souverain : l'équivalent pour le même palier
| Palier | Usage | API au token (prix en € par million de tokens, entrée / sortie) | GPU dédié, si la charge est constante |
|---|---|---|---|
| 7–14 B | chat, résumé, documents | OVHcloud Qwen3.5-9B : 0,10 / 0,15 | Scaleway L4 : 0,75 €/h |
| 27–32 B | agents simples, code simple | OVHcloud Qwen3.8-27B : 0,40 / 2,70 | Scaleway L40S : 1,40 €/h |
| 35–50 B | agents plus solides, plusieurs utilisateurs | Scaleway Qwen3.6 35B A3B (prix non relevé) | Scaleway L40S ou H100 : 1,40 à 2,52 €/h |
| 70–120 B | tâches lourdes | OVHcloud GPT-OSS 120B : environ 0,08 / 0,40 | Scaleway 1 ou 2 H100 : 2,52 à 5,04 €/h |
| 280 B et plus | modèles proches du cloud | Scaleway DeepSeek V4 Flash : 0,40 / 0,80 ; OVHcloud Qwen3.5-397B : 0,60 / 3,60 ; Scaleway GLM-5.2 : 1,80 / 5,50 | non pertinent : 19 000 à 27 000 $ par mois pour un serveur 8 GPU |
Prix d'achat : chiffres cités dans la vidéo ; les ordres de grandeur des deux premières lignes sont des estimations. Prix de location : Scaleway (L4, L40S, H100 PCIe), Spheron (H100 SXM en 8 GPU chez Scaleway, juillet 2026), Flopper (H200 chez OVHcloud, octobre 2026) ; un mois en continu compte 730 heures. Pour le dernier palier, 640 Go suffisent pour GLM-5.2 en 4 bits (environ 465 Go), pas pour les modèles de 1 To et plus.
1.7.4 Acheter une machine ou payer à l'usage
Pour les modèles proches du cloud, l'API souveraine bat l'achat local jusqu'à des volumes élevés. Louer un serveur de 8 GPU en continu (environ 19 000 $ par mois chez Scaleway, 27 000 $ chez OVHcloud) n'a de sens que pour un opérateur qui sert des centaines d'utilisateurs : on l'écarte. La vraie comparaison oppose l'achat d'une machine entière et le paiement au token.
| Option | Ce qu'on paie | Vitesse et utilisateurs | Coût pour 50 M tokens par mois | Coût pour 500 M tokens par mois |
|---|---|---|---|---|
| 4 DGX Spark achetés (environ 19 200 €) | la machine entière, utilisée ou non | quelques tokens par seconde, un utilisateur à la fois | environ 530 € (amortissement sur 36 mois, hors électricité et maintenance) | environ 530 €, mais un tel volume dépasse probablement la capacité de la machine |
| API Scaleway, DeepSeek V4 Flash (0,40 € / 0,80 €) | uniquement les tokens consommés | rapide, élastique, plusieurs utilisateurs | environ 24 € | environ 240 € |
| API OVHcloud, Qwen3.5-397B (0,60 € / 3,60 €) | uniquement les tokens consommés | rapide, élastique | environ 60 € | environ 600 € |
| API Scaleway, GLM-5.2 (1,80 € / 5,50 €) | uniquement les tokens consommés | rapide, élastique | environ 127 € | environ 1 270 € |
Hypothèses : 80 % de tokens en entrée, 20 % en sortie, sans cache de prompt. Un assistant documentaire pour 20 personnes consomme de l'ordre de 50 M tokens par mois ; un agent de code intensif peut dépasser 500 M par développeur (volumes de l'étude Pegatron). Scaleway indique un cache de prompt sur DeepSeek V4 Flash (Requesty), qui réduirait encore la facture des agents. Prix : Décodeur IA et catalogue OVHcloud.
À retenir. L'intérêt de l'API souveraine est de ne payer que ce dont on a besoin : un modèle de 400 milliards de paramètres coûte quelques dizaines d'euros par mois en usage modéré via une API souveraine, contre l'achat d'une machine entière en local, plus lente et réservée à un seul utilisateur. L'achat local ne se justifie que lorsque la donnée ne doit pas quitter les murs, ou au-delà de plusieurs centaines de millions de tokens par mois sur un modèle cher.
1.7.5 Où va la donnée, et où est-elle stockée ?
Avec les API d'OVHcloud et de Scaleway, on sait où la donnée est traitée (en France) et les deux hébergeurs s'engagent à ne pas réutiliser les prompts. Mais il s'agit d'une maîtrise contractuelle, pas physique : on fait confiance à l'hébergeur.
| Question | Machine locale | Scaleway Generative APIs | OVHcloud AI Endpoints |
|---|---|---|---|
| Où la requête est traitée | sur la machine du client | datacenter de Paris uniquement, selon Scaleway | datacenter de Gravelines, selon la documentation OVHcloud |
| Prompts et réponses conservés ? | seulement là où l'application les écrit (LM Studio garde les conversations en clair) | non par défaut : contenu ni lu ni réutilisé ; données d'usage anonymisées gardées jusqu'à 6 mois ; conservation possible jusqu'à deux semaines pour diagnostiquer un incident (politique de confidentialité) | OVHcloud annonce ne conserver que ce qui sert à la facturation (Nexeai) ; à confirmer dans les conditions particulières du service |
| Utilisés pour entraîner des modèles ? | non | non, selon Scaleway (sécurité des services IA) | non annoncé dans les sources consultées ; à vérifier contractuellement |
| Droit applicable | celui du client | société française, droit européen, hors Cloud Act | société française, droit européen, hors Cloud Act |
| Certifications | aucune requise | hébergeur certifié HDS ; pas de qualification SecNumCloud | hébergeur certifié HDS ; SecNumCloud sur Hosted Private Cloud, a priori pas sur AI Endpoints (offre Public Cloud), à confirmer |
| Ce qu'on ne maîtrise pas | rien hors de la machine | l'infrastructure mutualisée, la version exacte du modèle servi | idem ; avec les « modèles virtuels », le modèle cible peut changer automatiquement (documentation) |
À retenir. L'API souveraine garantit la localisation et l'absence de réutilisation, sur engagement de l'hébergeur. Pour un client, il faut l'écrire noir sur blanc : accord de sous-traitance RGPD, région de traitement, durée de conservation. En production et avec des données réelles, il faut appeler l'hébergeur en direct : un agrégateur comme OpenRouter, utile pour des tests sur données fictives (voir 3.6), ajoute un intermédiaire, souvent américain, dans la chaîne.
1.7.6 La méthode de choix
Trois questions, dans cet ordre :
- La donnée peut-elle sortir des murs ? Si non, machine locale : prendre le plus gros modèle qui tient en mémoire, avec une marge pour le contexte (voir 1.4).
- Sinon, API souveraine au token : choisir le modèle sur sa qualité, sans contrainte de mémoire, et écrire le contrat (voir 1.7.5).
- GPU dédié seulement si la charge est constante ou si le modèle manque aux catalogues (voir 1.7.2).
Dans les deux cas, on teste d'abord le modèle sur la vraie tâche avec des données fictives, via OpenRouter ou directement chez l'hébergeur (voir 3.3 et 3.6). La vitesse se mesure à part : en louant un GPU quelques heures pour le palier local visé, ou en appelant l'API aux heures de pointe.
À retenir. Jusqu'au palier 27–32 B, un poste de travail suffit. Les modèles qui rivalisent avec le cloud demandent une infrastructure de datacenter, donc en pratique une API souveraine.
Récapitulatif de la partie 1
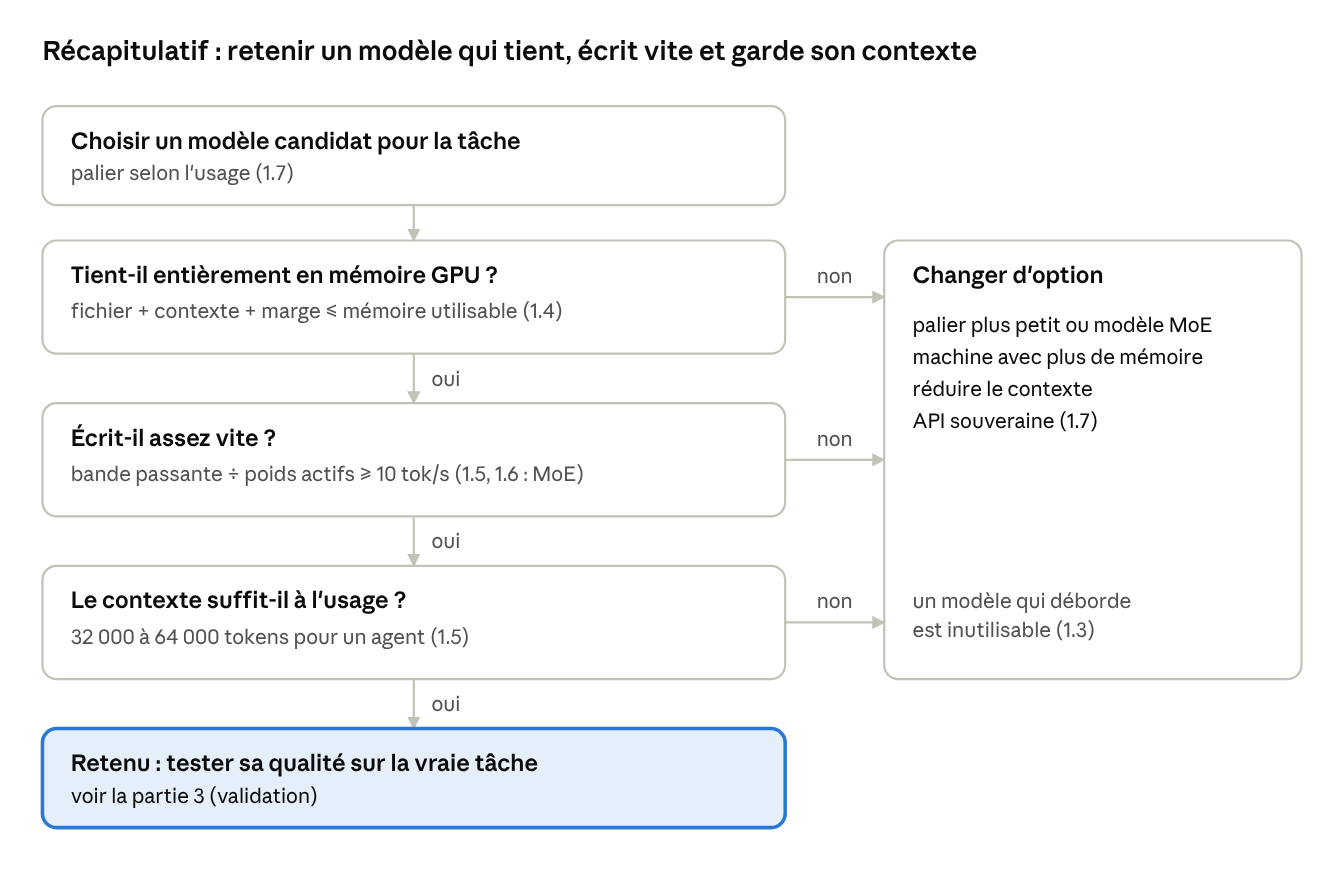
Trois questions suffisent pour juger un modèle sur une machine : tient-il en mémoire GPU, écrit-il assez vite, garde-t-il assez de contexte. Un seul « non » impose de changer d'option ; trois « oui » ouvrent le test de qualité de la partie 3. Avec une API souveraine, les deux premières questions tombent : restent la qualité, le coût du contexte et le débit.
Lien avec l'étude Pegatron
L'étude confirme le dernier point. GLM-5.2, le meilleur modèle ouvert au moment de l'étude (juillet 2026), occupe environ 465 Go même en NVFP4, soit au minimum 4 GPU B200. Le seul modèle ouvert qui s'approche de Claude n'est donc pas « local » au sens de la vidéo. Et sa vitesse (2,8 fois celle de Claude Opus) ne fait pas gagner de temps, car les réparations s'accumulent.
Partie 2 : installer, régler et mesurer un modèle
Objectif de la partie : savoir mettre en service un modèle de deux façons, en local ou via une API souveraine, en régler les paramètres qui conditionnent la justesse des réponses, et mesurer soi-même ce qu'on obtient.
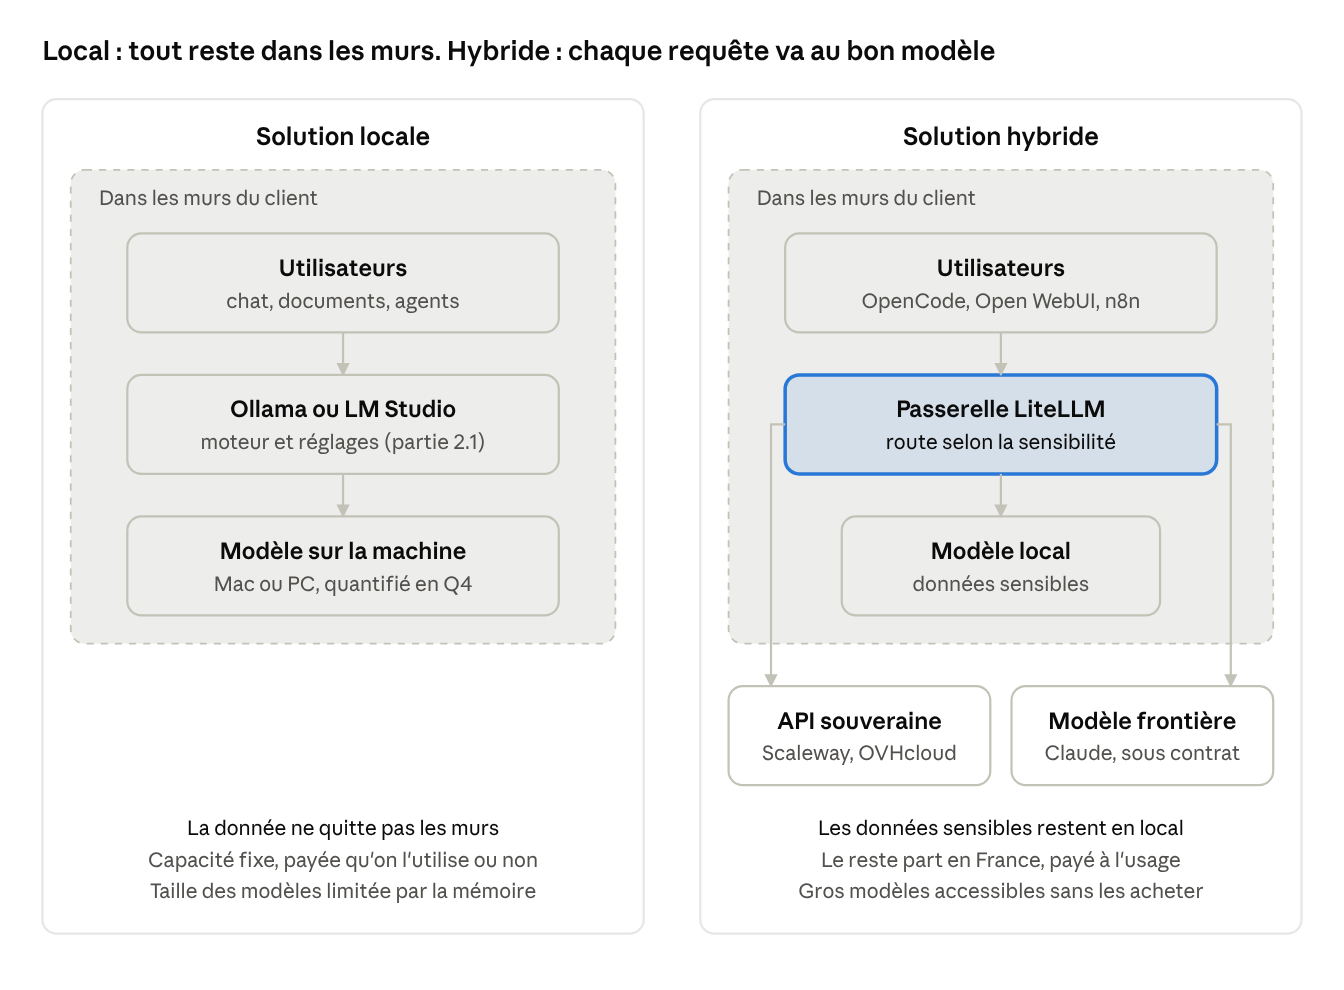
En local, tout passe par une machine dans les murs du client. En hybride, une passerelle envoie les données sensibles au modèle local et le reste vers une API souveraine ou un modèle frontière, qui sortent des murs (ligne pointillée). La section 2.1 détaille la solution locale, la 2.2 les API souveraines, la 2.3 les compare ; la passerelle qui les combine est décrite en 4.3.
2.1 Le modèle local : LM Studio et Ollama
2.1.1 Deux outils, deux rôles
| Outil | Rôle | Pour qui |
|---|---|---|
| LM Studio | découvrir et tester des modèles sans terminal ; indique avant téléchargement si un modèle tient en mémoire | le poste de test |
| Ollama | la « prise » standard sur laquelle se branchent agents, n8n et code ; expose une API | le serveur |
Les deux reposent sur llama.cpp et ne partagent pas leurs fichiers de modèles. Pour LM Studio, télécharger la version standard et non la variante avec agent, en partie payante.
À retenir. LM Studio sert à choisir, Ollama sert à brancher. On installe les deux.
2.1.2 Les trois réglages qui comptent dans LM Studio
- Déchargement GPU au maximum : tant que le modèle tient, il doit être entièrement en GPU.
- Taille du contexte : 8 192 tokens coûtent environ 1 Go de mémoire, 16 000 tokens environ 2 Go.
- Réflexion activée ou non : elle améliore les tâches complexes mais peut ajouter des dizaines de secondes par réponse ; elle se plafonne par un budget de tokens.
Deux habitudes à prendre : lire la fiche du modèle (Ministral recommande une température inférieure à 0,1, contre 0,8 par défaut), et vérifier dans cette fiche les capacités réelles (outils, vision), car les étiquettes affichées par LM Studio peuvent être fausses. Éviter les versions « base », non entraînées à répondre.
À retenir. Déchargement GPU, contexte et réflexion sont les trois leviers du compromis vitesse-qualité. La fiche du modèle fait foi, pas l'interface.
2.1.3 RAG ou lecture complète : l'arbitrage
Même tâche dans les deux cas : synthétiser les plaintes de 100 notes clients sur un trimestre, avec Ministral 14B sur le Mac mini.
| Configuration | Ce que fait LM Studio | Premier mot | Résultat |
|---|---|---|---|
| Contexte 8 192 tokens | le document ne tient pas : bascule en RAG sur 3 extraits | 19 s | 5 clients en retard trouvés sur 18 |
| Contexte 16 384 tokens | lecture du document complet | 160 s | bien meilleur, une erreur de comptage subsiste (45 annoncés au lieu de 25) |
À retenir. Le RAG est rapide et juste pour une question précise, mais faux pour une synthèse. La lecture complète est lente sur Mac (le préfill est son point faible) et reste imparfaite : la relecture humaine est obligatoire.
2.1.4 Ollama en cinq commandes
ollama pull télécharge un modèle, ollama run le lance dans le terminal, ollama ls liste les modèles, ollama stop en décharge un. ollama ps montre les modèles chargés : part GPU/CPU, contexte réservé, mémoire occupée.
À retenir. ollama ps est l'outil de diagnostic principal : la colonne processeur doit afficher 100 % GPU.
2.1.5 Le piège de la troncature silencieuse
Sur cette machine, Ollama attribue par défaut 4 096 tokens de contexte. Démonstration : une consigne (« commence chaque réponse par une phrase donnée »), puis le PDF de 100 notes. Le prompt fait 10 972 tokens ; Ollama n'en garde que 2 051, ceux de la fin. La consigne et les quatre cinquièmes des notes disparaissent. Le modèle annonce avec assurance 6 clients en retard au lieu de 18, sans aucun avertissement. Seul le journal d'Ollama révèle la coupe.
À retenir. Un contexte trop petit ne provoque pas d'erreur : il produit une réponse plausible et fausse. Dans un agent, cela se traduit par des consignes oubliées, des outils perdus, voire une action interdite exécutée.
2.1.6 Corriger avec un Modelfile
Trois façons de changer le contexte : le réglage de l'application, la variable OLLAMA_CONTEXT_LENGTH, ou un Modelfile. Le Modelfile est la meilleure : il crée un modèle nommé (ici « ministral-agent ») avec num_ctx 32768 et temperature 0.05, et il prime sur les deux autres réglages.
Résultat : consigne respectée, sources complètes, 81 s de préfill à 129 tok/s, écriture à 12 tok/s. Le modèle occupe 9,8 Go pour un fichier de 6 Go, car le contexte est réservé dès le chargement.
Variables utiles :
OLLAMA_KEEP_ALIVE: durée de maintien en mémoire (5 minutes par défaut, -1 pour toujours).OLLAMA_KV_CACHE_TYPE: compression du contexte ; F16 conseillé, Q8 acceptable, Q4 dégrade le suivi des consignes.OLLAMA_MAX_LOADED_MODELS: nombre de modèles chargés en même temps.
À retenir. Un Modelfile versionné garantit le même contexte et la même température chez chaque client. C'est la bonne pratique de configuration.
2.1.7 L'API et l'appel d'outils
Ollama expose sur le port 11434 une API compatible avec les formats d'OpenAI et d'Anthropic. Une application qui sait parler à OpenAI peut parler à Ollama en changeant l'adresse du serveur. Démonstration d'appel d'outil : on déclare un outil fictif « envoyer un mail » et on demande de décaler une réunion. Le modèle ne répond pas par du texte mais par une demande structurée d'appel d'outil, avec le contenu du mail.
À retenir. Le modèle demande l'action, le harness l'exécute. Appeler le modèle nommé du Modelfile garantit le bon contexte, que l'API ne permet pas de choisir.
2.2 Le modèle souverain : les API de Scaleway et d'OVHcloud
Ici, on n'installe ni moteur ni modèle : on consomme un modèle hébergé en France, au token, avec la même interface qu'Ollama. Le travail se déplace de l'administration de la machine vers le choix du modèle, la maîtrise des coûts et le contrat.
2.2.1 Ce qu'on met en place
| Étape | Scaleway Generative APIs | OVHcloud AI Endpoints |
|---|---|---|
| Compte et clé | clé secrète créée dans la gestion des accès (IAM) de la console | clé créée dans le Manager : Public Cloud, puis AI & Machine Learning, puis AI Endpoints |
| Adresse de l'API | https://api.scaleway.ai/v1 (guide n8n) |
https://oai.endpoints.kepler.ai.cloud.ovh.net/v1 (LlamaIndex) |
| Essai gratuit | premier million de tokens offert (Scaleway) | utilisation gratuite avec limites de débit, clé pour des limites plus hautes |
| Lieu de traitement | Paris | Gravelines |
À retenir. Mise en service en quelques minutes, sans matériel. La seule installation à prévoir côté client est éventuellement une passerelle (voir 2.2.2).
2.2.2 Brancher les outils
Les deux API sont compatibles avec le format d'OpenAI. On retrouve donc exactement les trois paramètres d'Ollama (voir 4.1.2) : l'adresse, la clé et le nom du modèle. n8n, AnythingLLM ou OpenClaw se configurent de la même façon. Pour l'hybride, une passerelle comme LiteLLM peut présenter le modèle local et les modèles souverains derrière une seule adresse, et choisir la destination selon la sensibilité de la donnée (voir 4.3).
À retenir. Local et souverain parlent le même langage : passer de l'un à l'autre se résume à changer l'adresse et le nom du modèle. C'est ce qui rend l'hybride simple à mettre en œuvre.
2.2.3 Les réglages qui changent
- Le contexte devient un coût, plus une contrainte de mémoire. Pas de
num_ctxà régler : chaque modèle accepte un contexte maximal (262 000 tokens pour les Qwen d'OVHcloud, 256 000 pour GLM-5.2 et DeepSeek V4 Flash chez Scaleway). Mais chaque token envoyé est facturé : un agent qui renvoie tout son historique coûte cher. - La quantification est imposée. OVHcloud l'affiche dans son catalogue (FP8 pour Qwen3.8-27B, BF16 pour Qwen3.5-9B) ; on ne peut pas la changer.
- Température et réflexion se passent dans chaque requête, comme avec l'API d'Ollama.
- Figer le nom du modèle. OVHcloud propose des « modèles virtuels » qui basculent automatiquement vers un modèle plus récent (documentation) : pratique, mais un résultat validé peut changer sans prévenir.
- Limites techniques. Limites de débit par clé, requêtes limitées à 2 Mo chez OVHcloud (documentation) ; traitement par lots à moitié prix chez Scaleway pour l'asynchrone.
À retenir. En local, on règle la machine ; en API, on règle la requête et on surveille la facture. Figer la version du modèle est l'équivalent du Modelfile.
2.2.4 Mesurer
Les mêmes indicateurs qu'en local (voir 1.5) se mesurent côté client : temps avant le premier token, vitesse d'écriture et coût par requête, que la réponse de l'API indique en tokens d'entrée et de sortie. Scaleway est mesuré publiquement à environ 168 tok/s et 1,2 s avant le premier token sur GPT-OSS 120B ; OVHcloud ne publie pas ces chiffres (Décodeur IA). Les deux tournent sur des ressources mutualisées : les performances varient selon la charge des autres clients (Scaleway).
À retenir. Aucun engagement de débit n'est contractualisé : il faut mesurer soi-même, aux heures de pointe, avant de promettre un temps de réponse à un client.
2.2.5 Les pièges propres à l'API
Un agent sans cache de prompt peut consommer des centaines de millions de tokens par mois. Le catalogue peut retirer un modèle : il faut un modèle de repli. Les quotas peuvent étaler un traitement massif sur la nuit. Enfin, avec des données réelles, on appelle l'hébergeur en direct et on écrit région, conservation et non-réutilisation dans l'accord de sous-traitance (voir 1.7.5).
À retenir. Les risques de l'API sont économiques et contractuels, là où ceux du local sont techniques.
2.3 Comparaison et conclusion
| Critère | Modèle local | Modèle via API souveraine |
|---|---|---|
| Mise en service | achat, installation, réglages : de quelques heures à quelques jours | une clé et une adresse : quelques minutes |
| Taille de modèle accessible | limitée par la mémoire de la machine | jusqu'à 400 B et plus |
| Contexte | limité par la mémoire, coupé sans avertir si mal réglé | grand, mais facturé à chaque token |
| Quantification | au choix | imposée par l'hébergeur |
| Vitesse | 7 à 14 tok/s sur un Mac, préfill lent | environ 170 tok/s mesurés chez Scaleway, variable |
| Plusieurs utilisateurs | 1 à 3 avec Ollama | élastique |
| Coût | fixe : la machine entière, qu'elle serve ou non | variable : uniquement ce qu'on consomme |
| Où va la donnée | reste dans les murs, si le harness n'appelle pas l'extérieur (voir 4.1.1) | France, sous engagement contractuel de l'hébergeur |
| Exploitation | sécurité, mises à jour, pannes à la charge du prestataire | assurée par l'hébergeur |
| Principal risque | réponse fausse par troncature ou modèle trop petit | coût des agents, dépendance au catalogue |
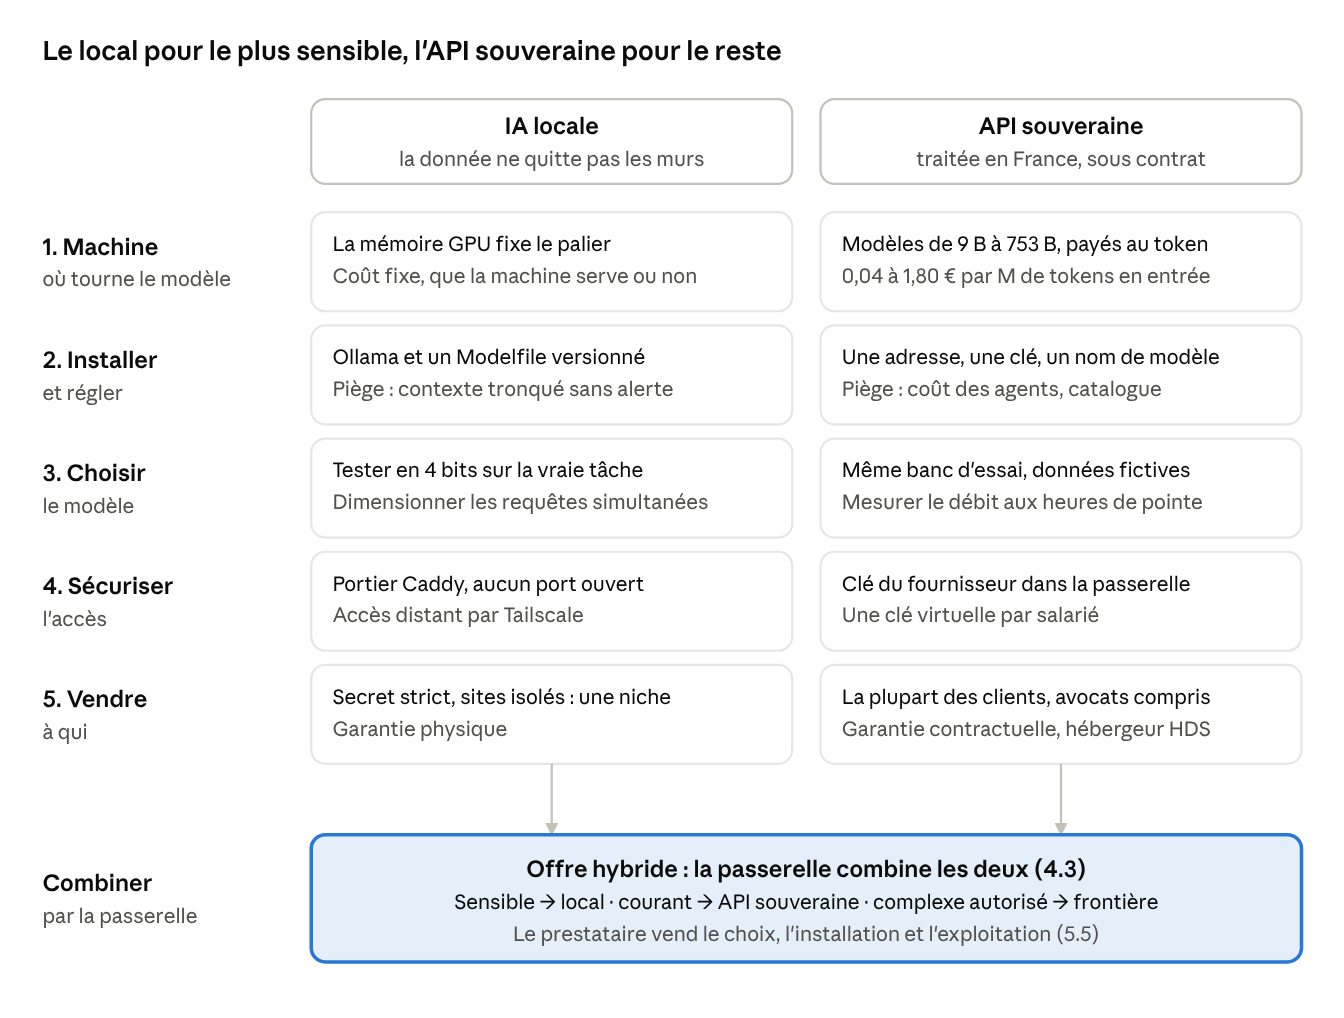
Conclusion. Les deux modes se branchent de la même façon et se complètent. Le local est réservé aux données qui ne doivent pas quitter les murs ; l'API souveraine couvre le reste, avec des modèles plus gros et plus rapides, payés à l'usage. Une passerelle qui route selon la sensibilité de la donnée permet de combiner les deux dans une même offre : c'est le cœur de l'approche hybride (voir 4.3).
2.3.1 L'usage au quotidien, face à Claude Code et à l'application Claude
| Besoin | Avec Claude | En local ou souverain | Remarques |
|---|---|---|---|
| Agent de code dans le terminal ou l'IDE | Claude Code | Opencode (open source, licence MIT, compatible avec tous les fournisseurs) ; ou Claude Code redirigé vers un autre modèle | Opencode est l'outil utilisé par Pegatron avec GLM (étude) |
| Chat et travail sur documents | application Claude (web, bureau) | AnythingLLM (application de bureau, RAG intégré) ou Open WebUI (portail web partagé, auto-hébergé) | AnythingLLM pour un poste, Open WebUI pour une équipe |
| Automatisation | intégrations Claude | n8n, avec un nœud de modèle compatible OpenAI | même branchement qu'en 4.1.3 |
| Assistant clé en main, sans installation | abonnement Claude | Le Chat de Mistral (offre Pro ou Entreprise) | solution européenne en SaaS, mais on choisit Mistral et non le modèle (guide) |
Claude Code peut-il servir avec un autre modèle ? Oui, en le redirigeant par variables d'environnement. Depuis la version 0.14, Ollama comprend directement le format d'API d'Anthropic (Ollama). Il faut aussi rediriger les niveaux de modèle que Claude Code demande en interne (KDnuggets). Les API de Scaleway et d'OVHcloud parlent le format OpenAI : il faut alors une passerelle de traduction comme LiteLLM (à tester). Deux limites : Claude Code est optimisé pour les modèles Claude, et des blocages avec des modèles locaux sont signalés (ticket GitHub). Pour un usage durable avec des modèles ouverts, Opencode est le choix le plus naturel.
À retenir. L'utilisateur garde une interface familière ; seul change le modèle qui répond derrière. Le branchement et la sécurisation sont détaillés en partie 4.
Lien avec l'étude Pegatron
L'étude montre le même mécanisme à plus grande échelle. Un agent renvoie tout son contexte à chaque appel : environ 480 000 tokens par requête en moyenne côté Claude. C'est le cache de préfixe qui rend ces boucles supportables (99,3 % de succès chez Anthropic, 86,4 % en local avec vLLM). Elle montre aussi qu'un grand contexte ne suffit pas : avec 1 million de tokens disponibles, le modèle local inventait des chemins d'import et utilisait des signatures d'API obsolètes. Comme dans la démo de troncature, l'échec est silencieux et se découvre à l'exécution.
Partie 3 : choisir le modèle et l'hébergement d'un client
Objectif de la partie : choisir un modèle et son hébergement, machine sur site ou API souveraine, pour un client, sans pouvoir mesurer sur sa machine, qui n'existe pas encore, ni sur ses données, qu'on ne peut pas sortir.
Cette partie décrit en fait le déroulé d'une mission de conseil. Les sections ci-dessous détaillent chaque étape ; la proposition est le point de décision du client, et le pilotage relance la validation à chaque trimestre.
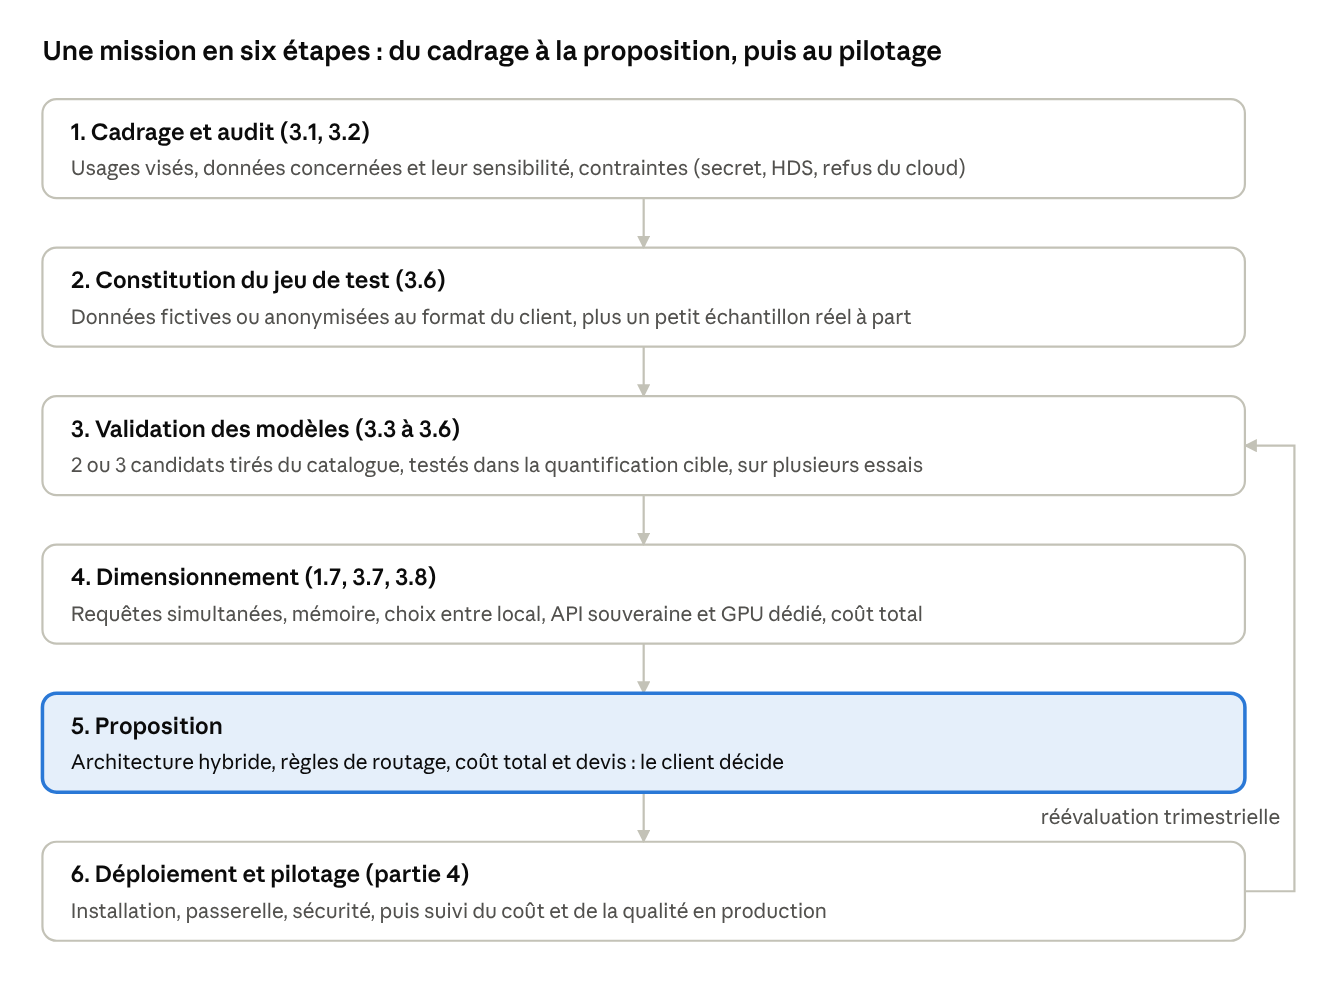
3.1 L'ordre de décision
- La tâche choisit le modèle.
- Le modèle et le nombre de requêtes simultanées fixent la mémoire nécessaire.
- La mémoire fixe le palier.
- Le choix sur site ou API souveraine vient en dernier ; la sensibilité des données le tranche (voir 1.7.6).
À retenir. « Combien de RAM me faut-il ? » est la dernière question à poser, pas la première.
3.2 Trois usages types
| Usage | Ce que fait l'IA | Exigence sur le modèle |
|---|---|---|
| Assistant documentaire | répond à partir des fichiers du client, cite ses sources, rédige des brouillons ; l'humain décide | modéré |
| Agent avec outils | enchaîne des actions : lire, écrire, appeler des outils | contexte long et appels d'outils fiables |
| Tâches lourdes | très longs documents, raisonnement solide | gros modèles |
À retenir. Un modèle de 8 milliards de paramètres appelle correctement un outil bien cadré, mais seul un test dit jusqu'où il faut monter pour enchaîner plusieurs étapes.
3.3 Valider le modèle avant d'acheter
Pour sortir du problème de l'œuf et de la poule, on teste en ligne le modèle candidat, sur la vraie tâche du client, avec des données fictives qui imitent les siennes (voir 3.6). OpenRouter donne accès à des centaines de modèles, dont la plupart des modèles ouverts ; OVHcloud et Scaleway en proposent aussi. Chaque essai coûte quelques centimes.
Le workflow n8n fourni dans le kit fait passer deux prompts au modèle candidat : compter les clients par type de plainte, et lister chaque note mentionnant un retard. Un modèle de référence (Claude Sonnet) vérifie la cohérence des deux réponses. On répète 5 à 10 fois : un seul essai ne prouve rien.
À retenir. Le test en ligne juge la qualité, pas la vitesse : les fournisseurs tournent sur des grappes de serveurs sans rapport avec la machine du client. Cette étape d'audit est en soi un livrable facturable.
3.4 Tester la bonne quantification
Les fournisseurs servent généralement les modèles en 16 ou 8 bits, plus précis que le 4 bits qui sera installé en local. Un test classique surestime donc la qualité. OpenRouter permet de filtrer les fournisseurs par quantification et de n'autoriser que ceux qui servent le modèle en 4 bits.
À retenir. Tester dans la quantification qui sera déployée. Un bon résultat en 4 bits en ligne est un bon indicateur, pas une garantie : le format 4 bits d'un serveur vLLM n'est pas le Q4 de llama.cpp. La validation finale se fait sur la machine du client (voir 3.6).
3.5 Ce que révèle le test
- Un modèle de 8 milliards de paramètres ne suffit pas pour retrouver sans oubli les bonnes notes parmi 100.
- Qwen 3.8 27B réussit à chaque essai.
- Gemma 4 26B, du même palier, échoue sur cette tâche.
À retenir. Deux modèles du même palier ne se valent pas sur une tâche donnée. Aucune fiche technique ne remplace le test sur la vraie tâche.
3.6 Benchmarker une fois pour toutes ou pour chaque client ?
Les deux, à deux niveaux différents : un catalogue mutualisé par type d'usage, construit une fois et rafraîchi chaque trimestre, puis un test court et ciblé pour chaque client.
Niveau 1 : le catalogue par usage (mutualisé). Pour chaque usage type (synthèse, extraction, RAG, rédaction, agent avec outils, code), on compare plusieurs modèles et déploiements : local en Q4, API OVHcloud ou Scaleway, modèle frontière comme référence. On mesure la qualité (juge automatique et contrôle humain), la stabilité, la vitesse et le coût par tâche. Les données sont fictives ou publiques ; OpenRouter est utile ici. Un passage complet chaque trimestre suit le rythme des modèles et des prix.
Niveau 2 : le test ciblé par client (court). On retient 2 ou 3 candidats dans le catalogue. On les teste sur un jeu de données qui imite celui du client (format, longueur, vocabulaire, pièges). On valide enfin sur un petit échantillon réel, dans un environnement conforme : la machine du client, ou une API souveraine appelée en direct sous contrat.
Peut-on benchmarker sur de fausses données ? Oui, c'est la règle pour le catalogue et pour le premier tri. La vidéo le fait d'ailleurs avec 100 notes clients fictives. Mais les données synthétiques sont souvent plus propres que les vraies : elles ignorent le jargon, les documents mal numérisés et les cas limites. D'où la validation finale sur un échantillon réel, même petit.
À retenir. Le catalogue par usage est l'actif qui se mutualise et qui se vend : il réduit le test client à quelques jours. OpenRouter sert au catalogue sur données fictives ; les données réelles du client ne passent que par sa machine ou par un hébergeur souverain sous contrat.
3.7 Dimensionner pour plusieurs utilisateurs
Ollama réserve un contexte complet par requête traitée en même temps :
mémoire = modèle + contexte × requêtes simultanées + marge du moteur
Exemple avec Ministral 8B et 32 000 tokens de contexte : 9,8 Go pour un utilisateur, 14,4 Go pour deux (débordement sur un Mac 16 Go), 19 Go pour trois (il faut un Mac 32 Go). Par défaut, Ollama traite une requête à la fois : la mémoire ne déborde pas, mais l'attente s'allonge. Avec des documents longs (près de 2 minutes chacun sur le Mac mini), le quatrième utilisateur attend au moins 5 minutes.
Avec une API souveraine, la question de mémoire disparaît : la capacité est élastique et facturée au token. Elle est remplacée par une autre : le débit n'est pas garanti, il se mesure aux heures de pointe (voir 2.2.4).
À retenir. On dimensionne sur les requêtes simultanées, pas sur l'effectif : dix salariés envoient rarement plus de deux ou trois requêtes à la fois. ollama ps dit la vérité sur la machine réelle.
3.8 Local ou hébergé : les options matérielles
| Palier | Modèles types | Sur site | Remarque |
|---|---|---|---|
| Assistant documentaire, 1 à 3 personnes | Gemma 4 12B, Qwen 3.5 9B, Ministral 8B | Mac mini 16–32 Go, mini-PC Ryzen AI 32 Go, ou RTX 5060 Ti 16 Go | 32 Go dès deux ou trois utilisateurs |
| Agents à plusieurs étapes | Qwen 3.8 27B, Qwen 3.6 35B, Gemma 4 26B | Mac Studio 48 Go, Ryzen AI 64 Go, ou deux RTX 5060 Ti | prix très variables |
| Gros modèles | GPT-OSS 120B, Mistral Small 4 | Mac Studio 128 Go, Ryzen AI 128 Go, ou DGX Spark (6 000 à 7 800 € constatés) | une carte de 96 Go coûte plus cher qu'un DGX Spark |
| Modèles proches du cloud | DeepSeek V4 Flash, Qwen3.5-397B, GLM-5.2 | plusieurs DGX Spark reliés, ou serveur 8 GPU loué 19 000 à 27 000 $ par mois (voir 1.7.4) | hors de portée de la plupart des clients |
L'alternative hébergée en France reste OVHcloud ou Scaleway (formules en 1.7.2). Hostinger est écarté : ses serveurs GPU sont aux États-Unis ou au Royaume-Uni.
À retenir. Beaucoup de clients veulent en réalité du souverain plutôt que du local. Le client paie le matériel ; le prestataire vend le bon choix et l'assurance de ne pas racheter une machine six mois plus tard. Vérifier disponibilité et prix avant de promettre : en 2026, la mémoire coûte cher et certains modèles de Mac sont difficiles à trouver.
Lien avec l'étude Pegatron
L'étude classe chaque modification de code par difficulté, comme la vidéo classe les usages, mais le résultat est plus sévère. Même sur les tâches faciles (un seul fichier modifié), la configuration locale produit 86,9 % de commits de réparation contre 63,4 % avec Claude ; sur les tâches difficiles, 46,5 % contre 15,1 %. L'écart de qualité ne se limite donc pas aux tâches complexes. Elle confirme aussi la méthode de la vidéo : seule une mesure sur sa propre charge de travail permet de conclure, les benchmarks publics étant trop optimistes.
Partie 4 : brancher les agents et sécuriser l'accès
Objectif de la partie : relier des outils réels au modèle, puis sécuriser l'accès dans chacun des trois cas : serveur local (4.1), API souveraines (4.2) et passerelle qui combine les deux (4.3).
4.1 L'IA locale, hébergée sur sa machine
4.1.1 Le modèle est le cerveau, le harness est le corps
Le modèle prédit le token suivant. Le harness lui donne des outils et des instructions, garde la mémoire de la conversation et décide s'il agit seul ou demande une validation.
À retenir. Un modèle local ne garantit pas que rien ne sort : le harness peut lui-même appeler internet ou un modèle distant.
4.1.2 Brancher un harness en trois paramètres
- L'URL de base : l'adresse du serveur Ollama, port 11434, suffixe
/v1pour le format OpenAI. - Une clé API : Ollama n'en a pas, mais beaucoup d'outils refusent un champ vide ; on met une valeur quelconque.
- Le nom du modèle : de préférence celui créé par le Modelfile.
Pour une vingtaine d'outils, la commande ollama launch écrit la configuration automatiquement. Pour appeler le serveur depuis une autre machine, il faut activer l'exposition au réseau.
À retenir. Tout harness compatible OpenAI peut parler à Ollama. Par défaut, Ollama n'écoute que la machine locale : c'est l'ouverture au réseau qui crée le risque.
4.1.3 Quatre harnesses démontrés
| Harness | Rôle | Point notable de la démo |
|---|---|---|
| OpenClaw | agent personnel | configuration par l'interface ou par ollama launch ; choisir « local only » pour exclure les modèles cloud |
| DeepSeek Harness | agent de code open source (licence MIT) | installé sur un autre poste, connecté au serveur Ollama du réseau |
| n8n | automatisation | nœud agent avec un outil calculatrice : 18 sur 25 donne 72 %, calculé par l'outil et non par le modèle |
| AnythingLLM | interface de chat pour les salariés | RAG local par espace de travail, épinglage d'un document pour forcer sa lecture complète, base vectorielle partagée possible (Qdrant) |
Toutes les démos tournent sur un modèle 8B, faute de mémoire sur le Mac mini 16 Go. L'auteur le reconnaît : pour des agents chez un client, il faut au minimum un modèle 27B sur 48 Go.
À retenir. Le branchement fonctionne avec tous les outils courants. La démonstration prouve la plomberie, pas la qualité d'un agent multi-étapes.
4.1.4 Le parallélisme et ses limites
Ollama traite une requête à la fois ; les autres attendent. Une réponse de 300 tokens à 14 tok/s prend environ 21 s, donc le quatrième collègue attend une minute. Avec OLLAMA_NUM_PARALLEL=2, deux contextes de 32 000 tokens sont réservés : la mémoire passe à 14 Go et le modèle déborde sur le CPU (65 % GPU, 35 % CPU), ce qui ralentit les deux conversations.
À retenir. Pour des réponses courtes, la file d'attente suffit. Pour des agents et des documents longs, le parallélisme coûte de la mémoire et plafonne vite : au-delà de quelques utilisateurs, il faut un autre moteur comme vLLM.
4.1.5 Accéder au serveur à distance sans l'exposer
Ouvrir un port sur la box du client exposerait Ollama sur internet, sans mot de passe. La solution recommandée est Tailscale : un réseau privé chiffré entre machines autorisées, sans aucun port ouvert, gratuit jusqu'à 6 utilisateurs.
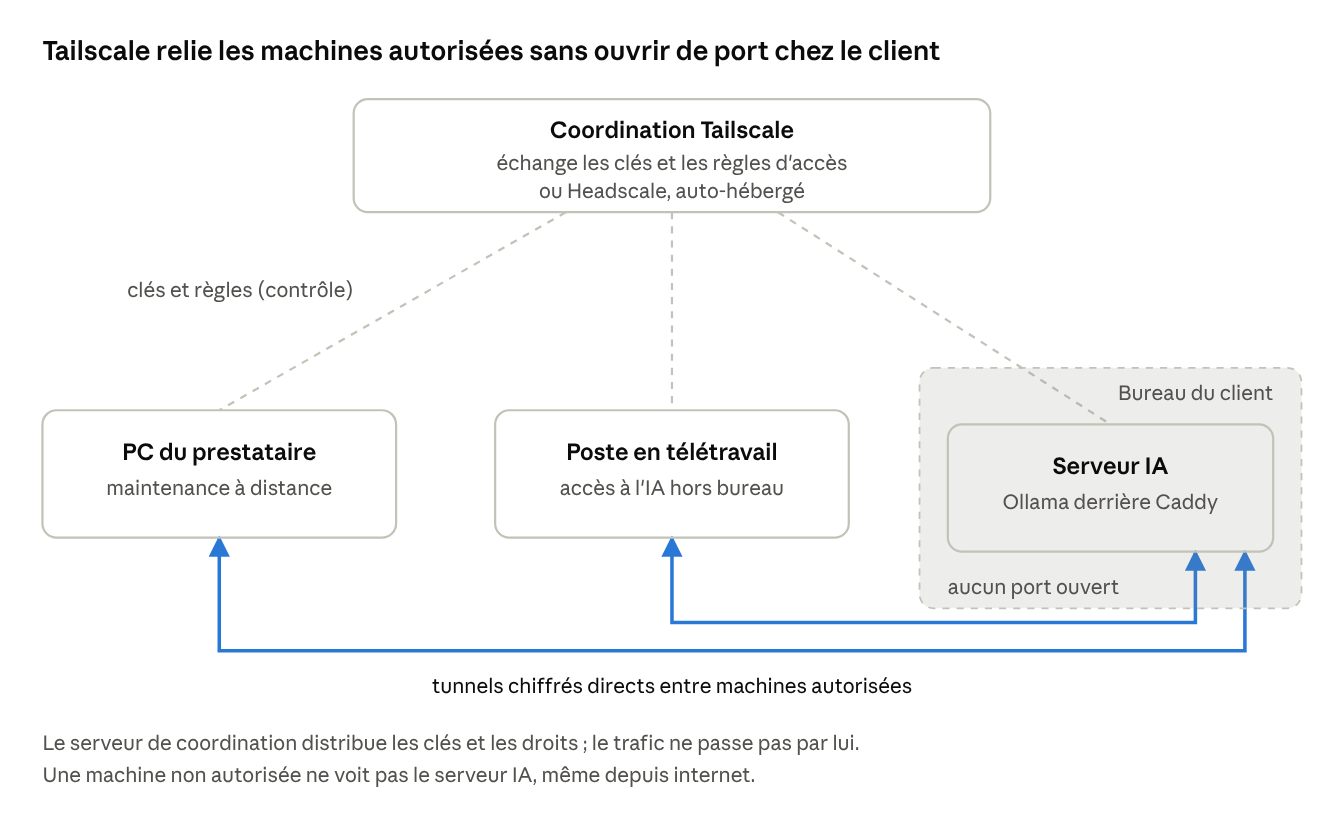
Les lignes pointillées ne transportent que des clés et des règles ; les requêtes vers le modèle passent par les tunnels directs. Pour ne dépendre d'aucun service tiers, la coordination peut être auto-hébergée avec Headscale, une alternative open source (SSD Nodes).
Prix. L'offre Personal est gratuite jusqu'à 6 utilisateurs. Au-delà, Standard coûte 8 $ et Premium 18 $ par utilisateur actif et par mois, soit environ 400 $ ou 900 $ par mois pour 50 personnes (prix d'août 2026, CostBench, SSD Nodes). Si les salariés accèdent au serveur depuis le bureau, seuls le prestataire et les télétravailleurs en ont besoin. À comparer avec le VPN existant de l'entreprise, ou avec Headscale.
À retenir. Jamais de port ouvert vers Ollama. L'accès distant passe par un réseau privé.
4.1.6 Les quatre règles de sécurité
- Un portier avec clé. Ollama n'écoute qu'en local. Un reverse proxy Caddy, sur un autre port (11435), exige une clé (erreur 401 sinon), bloque les actions d'administration comme la suppression de modèles (erreur 403) et redirige le reste vers Ollama. Une clé par personne est possible.
- Couper le cloud d'Ollama.
OLLAMA_NO_CLOUD=1empêche d'appeler les modèles étiquetés:cloud, exécutés sur les serveurs d'Ollama. - Purger LM Studio. Il conserve les conversations en clair ; le serveur Ollama, lui, ne journalise que qui a appelé et quand.
- Maîtriser les mises à jour. Désactiver la mise à jour automatique d'Ollama et tester chaque version sur une autre machine avant de la déployer.
À retenir. Ces règles distinguent un professionnel d'un amateur. Le piège des modèles :cloud est le plus insidieux : l'utilisateur croit travailler en local alors que ses données partent chez un tiers.
4.1.7 L'exploitation au quotidien
- Désactiver la mise en veille de la machine et rédiger une procédure de redémarrage après coupure de courant.
- Rendre les variables d'environnement permanentes (LaunchAgent sur Mac), car elles sont perdues au redémarrage.
- Mettre à jour un modèle en recréant le même nom via le Modelfile : les utilisateurs ne voient rien changer.
À retenir. Ces gestes constituent la ligne « maintenance mensuelle » du devis. Le client ne paie pas un Mac mini, il paie la garantie que ça tourne, que c'est à jour et que rien ne sort.
4.2 Les API souveraines (AI Endpoints et Generative APIs)
Avec OVHcloud AI Endpoints ou Scaleway Generative APIs, il n'y a plus de serveur de modèle à protéger : on protège des clés et une passerelle.
4.2.1 Ce qui change par rapport au local
Les deux services sont des API publiques, appelées en HTTPS et authentifiées par une clé créée dans la console du fournisseur (adresses en 2.2.1). Pas de machine à exposer, pas de port à ouvrir, pas de modèle à mettre à jour.
À retenir. La sécurité ne porte plus sur un serveur mais sur les clés API, et sur la passerelle qui les détient.
4.2.2 Faut-il Tailscale pour une entreprise de 50 personnes ?
Non, pas pour appeler les API : elles sont faites pour être jointes depuis internet, en HTTPS, avec une clé. Tailscale (ou un VPN) ne sert que si l'architecture comporte un composant privé que l'on ne veut pas exposer :
| Architecture | Tailscale ou VPN nécessaire ? |
|---|---|
| Postes, puis passerelle sur un petit serveur souverain exposé en HTTPS avec une clé par salarié, puis AI Endpoints | non : HTTPS et clés suffisent |
| Postes, puis passerelle installée au bureau, puis AI Endpoints | seulement pour les télétravailleurs ; le VPN existant de l'entreprise peut suffire |
| Architecture hybride avec un modèle local au bureau | oui pour accéder au modèle local à distance (voir 4.1.5) |
Pour une entreprise de 50 personnes sans modèle local, la solution la plus simple est donc une passerelle LiteLLM sur une petite instance souveraine, joignable en HTTPS, avec une clé virtuelle par salarié : aucun coût de VPN.
À retenir. Tailscale protège l'accès à un serveur privé. Avec des API souveraines seules, il est inutile ; il ne redevient utile que si l'on garde un modèle ou une passerelle dans les murs.
4.2.3 La sécurité propre aux API
- Ne jamais distribuer la clé du fournisseur sur les postes. Elle reste dans la passerelle ; chaque salarié reçoit une clé virtuelle LiteLLM, révocable, avec budget et suivi des coûts (LiteLLM).
- Cloisonner les clés côté fournisseur : une clé par projet ou par client, OVHcloud ayant renforcé la gestion fine des clés (CRN Asia).
- Plafonner et surveiller : budgets dans la passerelle, consommation dans la console du fournisseur.
- Protéger la passerelle exposée : HTTPS, mises à jour, accès d'administration restreint (voir 4.3.4).
À retenir. Une clé de fournisseur qui fuit, c'est une facture ouverte et des données envoyées par un inconnu. La passerelle est le seul endroit où elle doit exister.
4.2.4 L'exploitation
Plus de mise en veille, de coupure de courant ni de mise à jour de modèle à gérer : l'hébergeur s'en charge. Il reste à suivre la facture, les limites de débit et le catalogue, puisqu'un modèle peut être retiré ou remplacé (voir 2.2.5).
À retenir. L'exploitation passe de la machine au contrat : coûts, quotas, versions de modèles.
4.3 L'hybride : la passerelle qui combine local et souverain
Local et API souveraines parlent le même format : une passerelle peut donc les présenter derrière une seule adresse, avec un modèle frontière, et envoyer chaque requête vers la bonne destination. C'est la pièce que le prestataire installe et exploite.
4.3.1 Comment l'ensemble est branché
- Postes utilisateurs : Opencode pour les développeurs, AnythingLLM ou Open WebUI pour les autres, n8n pour les automatisations. Tous pointent vers une seule adresse.
- Passerelle (par exemple LiteLLM, installée chez le client ou sur un serveur souverain) : une clé par utilisateur, des journaux d'usage, des plafonds de coût, et une règle de routage selon la sensibilité de la donnée et la difficulté de la tâche.
- Destinations, choisies par la passerelle :
- modèle local (Ollama ou vLLM sur site) pour les données qui ne doivent pas sortir ;
- API souveraine (Scaleway ou OVHcloud, appelées en direct) pour les données confidentielles courantes ;
- modèle frontière (Claude sous contrat entreprise) pour les tâches complexes, sur données autorisées.
Exemple 1 : un développeur avec OpenCode.
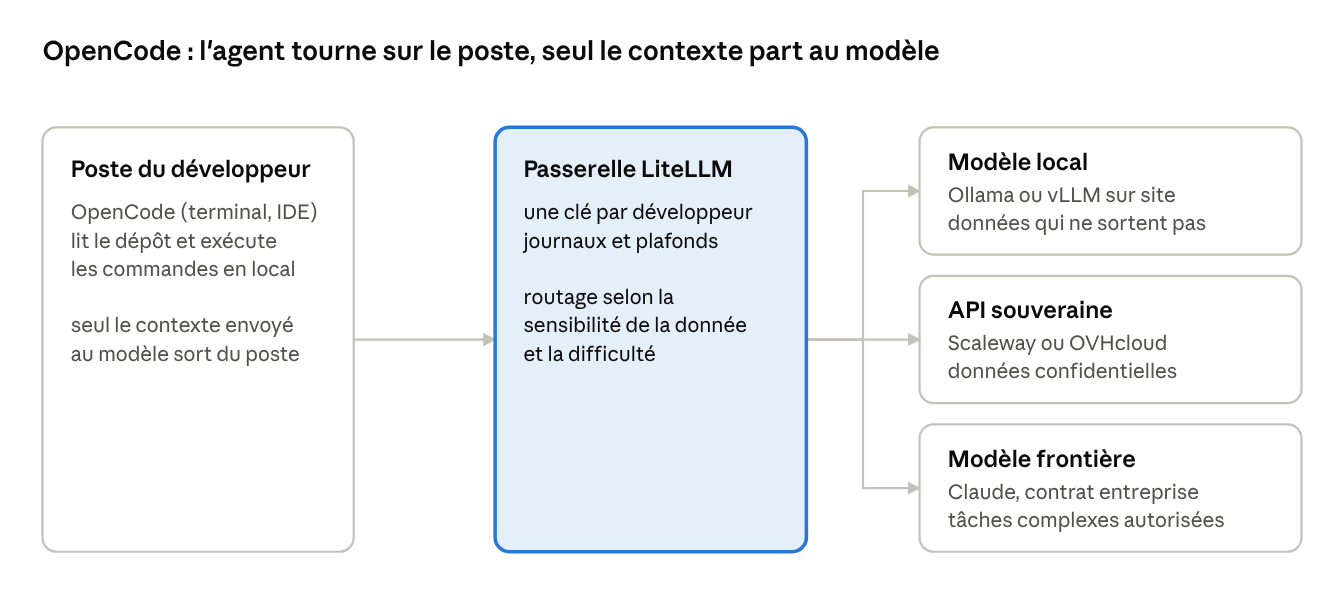
OpenCode lit le dépôt et exécute les commandes sur le poste ; seul le contexte de chaque requête part vers le modèle choisi par la passerelle.
Exemple 2 : une équipe avec Open WebUI.
Open WebUI : le portail d'équipe garde les conversations, la passerelle choisit le modèle
Open WebUI s'installe sur un serveur de l'équipe, chez le client ou chez un hébergeur souverain : c'est là que restent les conversations et les documents. La passerelle choisit ensuite le modèle, comme pour OpenCode.
À retenir. Chaque outil pointe vers une seule adresse ; la passerelle décide où part chaque requête. Vendre l'hybride, c'est vendre cette passerelle et ses règles, plus que les outils eux-mêmes.
4.3.2 La passerelle est-elle obligatoire ?
Non. Les API de Scaleway et d'OVHcloud sont compatibles OpenAI : OpenCode, Open WebUI ou n8n peuvent les appeler directement avec la clé du fournisseur. La passerelle devient utile dès qu'il faut l'un des points suivants.
| Besoin | Sans passerelle | Avec passerelle |
|---|---|---|
| Router entre modèle local, API souveraine et Claude | chaque outil configuré à la main, sans règle commune | une seule adresse, une règle de routage |
| Clés | la clé du fournisseur est copiée sur chaque poste ou outil | la clé reste dans la passerelle ; chaque salarié a une clé virtuelle révocable |
| Budgets et suivi des coûts | seulement au global, dans la console du fournisseur | par personne ou par équipe |
| Changer de modèle ou de fournisseur | reconfigurer chaque outil | une ligne dans la configuration de la passerelle |
À retenir. Pour quelques utilisateurs et un seul fournisseur, s'en passer est acceptable. Pour 50 personnes ou une offre hybride, elle devient la pièce centrale.
4.3.3 Où héberger la passerelle ?
Ce n'est pas un service fourni par Scaleway ou OVHcloud : chacun expose sa propre API, avec son seul catalogue, et ne route ni vers le modèle local du client ni vers Claude. Les « modèles virtuels » d'OVHcloud ne choisissent qu'entre modèles d'OVHcloud (documentation).
LiteLLM est un logiciel open source, auto-hébergé dans un conteneur, compatible OpenAI, avec clés virtuelles, suivi des coûts et interface d'administration (LiteLLM). Il prend en charge les modèles de Scaleway (guide Scaleway) et peut regrouper des modèles Ollama locaux et des API distantes derrière un même point d'entrée (exemple de déploiement). L'édition Entreprise payante ajoute l'authentification unique et les journaux d'audit, à partir de 250 $ par mois selon Railway (à confirmer auprès de l'éditeur).
| Emplacement | Quand le choisir | Point d'attention |
|---|---|---|
| Chez le client, sur site | dès qu'une partie des données ne doit pas sortir des murs | c'est le seul emplacement où les requêtes vers le modèle local ne quittent jamais le réseau du client |
| Sur un petit serveur souverain (instance Scaleway ou OVHcloud) | client sans données à garder sur site, ou plusieurs sites à servir | toutes les requêtes transitent par ce serveur : il entre dans le contrat et la sécurité |
| Opérée par le prestataire pour plusieurs clients | offre mutualisée | isoler strictement chaque client (clés, journaux, règles) ; le prestataire devient sous-traitant RGPD |
À retenir. La passerelle est la pièce que le prestataire installe et maintient ; c'est elle qui porte la valeur de l'offre hybride. Pour des données qui doivent rester dans les murs, elle doit être chez le client.
4.3.4 Comment la sécuriser ?
- Clé maîtresse et clés virtuelles : seul l'administrateur détient la clé maîtresse ; chaque utilisateur reçoit une clé virtuelle avec budget, suivie dans l'interface d'administration (LiteLLM).
- Chiffrement : la placer derrière un reverse proxy HTTPS, par exemple Caddy avec certificat automatique (exemple de déploiement).
- Accès réseau : sur site, réservée au réseau interne (et au VPN ou à Tailscale pour le télétravail) ; sur une instance souveraine, joignable seulement en HTTPS avec clé.
- Données stockées : la passerelle conserve clés et statistiques d'usage dans sa base ; vérifier sa configuration de journalisation pour ne pas conserver le contenu des requêtes.
- Mises à jour : logiciel open source très utilisé, à maintenir à jour comme tout composant exposé.
À retenir. La passerelle n'est pas obligatoire, mais c'est elle qui permet de ne jamais distribuer la clé du fournisseur et de router selon la sensibilité. Sécurisée par HTTPS, clés virtuelles et accès réseau restreint, elle devient l'unique point à protéger.
Récapitulatif de la partie 4
Récapitulatif : en local on protège un serveur, avec une API on protège des clés
En local, il faut un portier devant le serveur et un réseau privé pour y accéder à distance. Avec les API souveraines, les requêtes partent en HTTPS : la sécurité tient dans la passerelle, qui garde la clé du fournisseur et distribue des clés individuelles.
Lien avec l'étude Pegatron
Pegatron sert ses modèles avec vLLM, justement pour tenir la charge de plusieurs développeurs. L'étude signale aussi un risque absent de la vidéo : sur un serveur partagé entre équipes, le cache de préfixe peut être réutilisé d'une requête à l'autre, et les données de plusieurs équipes cohabitent en mémoire GPU. Pegatron isole donc les équipes par partitions GPU (MIG), espaces Kubernetes dédiés sous règles réseau strictes, chiffrement TLS mutuel et jetons nominatifs. Pour un serveur partagé entre plusieurs clients ou projets, une clé commune derrière Caddy ne suffit pas.
Partie 5 : vendre l'IA confidentielle
Objectif de la partie : savoir à qui vendre une offre d'IA confidentielle, locale, souveraine (API d'OVHcloud et de Scaleway) ou hybride, avec quel argument, sous quelle forme et avec quelles précautions juridiques.
Résumé : à qui vendre, quoi, comment, avec quels garde-fous
Le choix n'est pas binaire : un même client a des données de sensibilités différentes, et la passerelle envoie chaque requête vers la bonne destination. La plupart des clients, avocats compris, vivront surtout sur l'API souveraine ; le local reste réservé au plus sensible. Chaque mission suit ensuite les mêmes trois volets, dont l'installation et l'exploitation des serveurs de connexion forment le cœur récurrent.
Deux formes d'IA confidentielle à vendre. La vidéo ne vend que du local et ne cite l'API souveraine que comme point de comparaison de coût. Celle-ci tient pourtant la même promesse avec une garantie contractuelle plutôt que physique (voir 1.7.5 et 2.3) : c'est elle qui couvre la plupart des entreprises qui refusent les IA américaines.
5.1 Les trois réflexes qui font perdre une vente
- Vendre ce qu'on vient d'apprendre. Le client n'achète pas une installation d'Ollama, il achète un résultat sur une tâche précise et la garantie que ça tourne, que c'est à jour et que rien ne sort.
- Vendre des économies. L'argument ne tient pas (voir 5.2).
- Trop promettre. Annoncer « aussi bien que ChatGPT » ou installer une machine trop petite : à la première vraie question, le modèle se trompe et la crédibilité part avec lui.
À retenir. On vend un résultat et une garantie, prouvés par une démonstration que le client peut vérifier lui-même. Une machine louée quelques heures chez OVHcloud suffit pour préparer et faire la démonstration.
5.2 Pourquoi l'argument économique ne tient pas
L'auteur fait deux comparaisons. Pour un cabinet de 5 personnes, un abonnement d'équipe Claude (environ 1 080 € par an selon lui) coûte moins qu'un Mac Studio 48 Go à 3 659 €. À modèle égal (GPT-OSS 20B), l'API d'OVHcloud coûte environ 150 € par an, et un Mac mini 32 Go à 1 489 € met 8 ans à s'amortir. Les modèles locaux sont en outre moins bons sur les tâches complexes.
À retenir. Une offre locale vendue sur les économies perd face au premier devis cloud. On vend ce que le cloud ne peut pas vendre : des données qui ne sortent pas et une facture qui ne bouge pas.
Et l'API souveraine ? Même cabinet de 5 personnes, même usage très actif que dans l'exemple de la vidéo : 10 M tokens lus et 2 M écrits par jour, sur environ 220 jours ouvrés.
| Option | Coût annuel indicatif | Modèle | Où vont les données |
|---|---|---|---|
| Abonnement Claude d'équipe | environ 1 080 € (chiffre de la vidéo, non vérifié) | modèle frontière | chez un éditeur américain |
| Local, Mac Studio 48 Go | 3 659 € à l'achat, soit environ 1 220 € par an sur 3 ans, plus maintenance | 27 B en 4 bits, lent sur les longs documents | dans les murs |
| API souveraine, GPT-OSS 20B via OVHcloud | environ 150 € (0,04 € / 0,15 € par million de tokens) | modèle modeste | en France |
| API souveraine, DeepSeek V4 Flash via Scaleway | environ 1 230 € (0,40 € / 0,80 €) | modèle proche du cloud | en France |
| API souveraine, Qwen3.8-27B via OVHcloud | environ 2 070 € (0,40 € / 2,70 €) | même palier que le local, en 8 bits | en France |
Non comptés : la petite instance sans GPU qui héberge la passerelle, et la prestation (installation, maintenance). Prix des API : Décodeur IA et catalogue OVHcloud.
À retenir. L'API souveraine n'est pas automatiquement moins chère qu'un abonnement : à usage intensif sur un bon modèle, la facture rejoint celle de Claude. Ses vrais atouts sont ailleurs : on ne paie que la consommation (un usage modéré coûte quelques dizaines d'euros par an), on accède à des modèles plus gros que la machine locale, et les données restent en France. Le local garde son sens pour les seules données qui ne doivent pas sortir des murs.
5.3 Qui achète : ceux qui ne peuvent pas, ceux qui ne veulent pas
- Ceux qui ne peuvent pas envoyer leurs données dans le cloud, encadrés par des textes : avocats (le Conseil national des barreaux demande d'exclure les hébergeurs soumis à des lois extraterritoriales), experts-comptables, médecins, notaires. Selon l'auteur, plus de 350 000 professionnels en France, pour qui la violation du secret professionnel est un délit.
- Ceux qui ne veulent pas : les entreprises qui protègent tarifs, fichiers clients, formules ou stratégie. L'ANSSI recommande de proscrire les IA génératives grand public pour les données sensibles, alors que la moitié des TPE et PME utilisatrices s'en tiennent à des outils gratuits.
À retenir. Pour le premier groupe, on ne se compare pas à un abonnement à 20 €, mais au coût d'une violation du secret. La confidentialité ouvre la porte, mais c'est le cas d'usage qui fait signer.
Exemple : Hector, l'IA des avocats en contentieux. Hector est un outil spécialisé pour les avocats, intégré à Word : il analyse les dossiers, recherche la jurisprudence et rédige les actes (Transformations du droit). Il se présente comme conforme aux recommandations du CNB, avec des données hébergées exclusivement chez OVH à Gravelines, chiffrées, jamais utilisées pour entraîner les modèles et sans rétention par les modèles de langage (Hector). Le site ne précise pas quels modèles sont utilisés ni où ils tournent.
Il illustre la destination « API souveraine » de l'architecture hybride (voir 4.3) : interface dans Word, agent spécialisé par procédure, hébergement chez OVH, argument du secret professionnel plutôt que des économies.
Deux enseignements :
- Le souverain suffit à beaucoup d'avocats. Même chez ceux qui « ne peuvent pas » envoyer leurs données dans le cloud, un hébergement français sous droit européen est accepté ; le local n'est donc pas la seule réponse pour ce public.
- La concurrence y est déjà verticale. Pour les usages standard d'une profession (ici le contentieux), un logiciel spécialisé prêt à l'emploi sera préféré à une installation sur mesure. Un intégrateur doit viser ce que ces logiciels ne couvrent pas : outils internes, données propres au cabinet, plusieurs usages à relier, ou exigences plus strictes que le SaaS.
5.4 Trouver sa niche
Pour un secteur donné, cinq questions : où se fait le travail, où sont les données, sur quelle machine faut-il que ça tourne, où est le problème de confiance, et quelle tâche pénible est refaite plusieurs fois par semaine. Une réponse précise aux cinq définit une niche.
Niches citées : PME industrielles (procédures internes, documentation technique ; un élève de l'auteur aurait vendu 25 000 € une équipe d'agents locaux à un groupe de chauffage et climatisation), startups qui utilisent des modèles ouverts, et professions sous secret moins sollicitées (huissiers, mandataires judiciaires, commissaires aux comptes).
À retenir. Un seul secteur, cinq réponses précises : c'est ce qui transforme une compétence technique en offre vendable.
5.5 L'offre en trois volets
| Volet | Contenu | Prix indicatif selon l'auteur |
|---|---|---|
| 1. Audit et cadrage | cartographie des usages et des données sensibles, validation des modèles sur la vraie tâche avec des données fictives, choix entre local, API souveraine et frontière | 4 000 à 10 000 € HT (aide Bpifrance de 40 % possible, à vérifier) |
| 2. Installation clé en main | selon le cas : machine dimensionnée ; comptes OVHcloud ou Scaleway ; serveurs de connexion (passerelle, interface, accès) ; sécurité ; formation de l'équipe | à partir de 4 000 € HT, matériel à la charge du client |
| 3. Exploitation mensuelle | maintenance, suivi des coûts en tokens, réévaluation des modèles, support | de quelques centaines à quelques milliers d'euros par mois |
La formation est aussi une obligation : l'AI Act demande depuis février 2025 que les entreprises utilisatrices assurent la maîtrise de l'IA par leurs équipes.
À retenir. Le volet 1 se vend sans machine, dès maintenant : il suffit d'un client, d'une tâche précise et d'un accès à OpenRouter. C'est le pied dans la porte.
Lien avec l'étude Pegatron
L'étude nuance l'argument économique de la vidéo. Pour un seul utilisateur, elle lui donne raison : un serveur dédié coûte 44 % de plus que l'API de Claude, que le cache de prompt ramène à 0,57 $ par million de tokens. Mais un serveur partagé fait économiser 40 % du coût total, réparations comprises. Pour un prestataire, le levier économique n'est donc pas la machine posée chez un client, mais la mutualisation d'un serveur entre plusieurs utilisateurs ou clients. Une remise de 45 % sur l'API suffirait toutefois à annuler cet avantage.
Pour aller plus loin : pistes de réflexion
- Juridique avant de signer : certification HDS pour la santé (référentiel v2, hébergement dans l'Espace économique européen depuis le 16 mai 2026, ANS), contrat de sous-traitance RGPD, AI Act, licences des modèles, alternative aux modèles chinois.
- Le cœur d'une offre hybride : les serveurs de connexion (passerelle, interface, accès), leur installation et leur exploitation, plutôt que la machine (voir 4.3).
- Prix souverains : de 0,04 à 1,80 € par million de tokens en entrée selon le modèle ; débit non garanti par contrat (Décodeur IA).
- Marché : déjà occupé par les hébergeurs (OVHcloud, Scaleway), les éditeurs de modèles (Mistral, LightOn) et des logiciels verticaux comme Hector ; le créneau libre serait le conseil indépendant en choix de modèle, routage et coût total.
- Questions ouvertes : cache de prompt et engagements de débit chez OVHcloud et Scaleway ; transposition du modèle de coût de Pegatron aux paramètres français.
Sources
Source principale : Naier Saidane, « Masterclass agent IA en local, de zéro à pro », YouTube, 15 octobre 2026, analysée à partir de sa transcription. Toutes les démonstrations, mesures et recommandations des parties 1 à 5 en sont tirées, sauf mention contraire.
Sources complémentaires
- Peng et al., Inference Economics of Enterprise Coding Agents, arXiv 2607.13080
- Décodeur IA : comparatif des API IA souveraines (25 août 2026)
- OVHcloud AI Endpoints : catalogue
- OVHcloud : prix Public Cloud
- Next : lancement des GPU OVHcloud
- Flopper : prix GPU OVHcloud relevés en octobre 2026
- Scaleway : instances GPU
- Scaleway : grille Generative APIs
- Morph : classement des modèles de code (octobre 2026)
- vdf.ai : modèles locaux contre Claude Code
- ANS : publication du référentiel HDS v2
- ANS : référentiel HDS v2.1
- Grand View Research via GII : marché de l'IA souveraine
- MarketsandMarkets : marché de l'IA souveraine
- McKinsey : European Sovereign AI (juin 2026)
- Regolo : souveraineté des données IA en Europe
- LightOn : communiqué secteur public (juin 2026)
- Proactive Academy : panorama Mistral, Dust, LightOn, Docaposte
- Ask This Guy : 14 éditeurs français au test de la souveraineté
- Futurum : partenariat Kore.ai et Atos